活動內容簡介
企業在 AI 上的投入沒有停過:Copilot、GenAI 應用、AI Agent,一個接一個上線。但多數團隊心裡都有同一個疑問:「每個新的 AI 專案,為什麼還是要從資料整合重新開始?」
問題通常不在模型。Agent 要回答一個業務問題,往往得同時跨過好幾個系統,而資料分散在雲端、地端、各部門的 SaaS 裡,定義不一致,權限也各管各的
資料來源:Denodo《AI Trust Gap Report》(2026),由 Arlington Research 訪問 850 位企業主管。查看完整報告 ↗
多數企業的直覺是:要讓 AI 用上資料,就得先把資料搬進同一個地方,或把現有的資料湖、倉儲重蓋一次
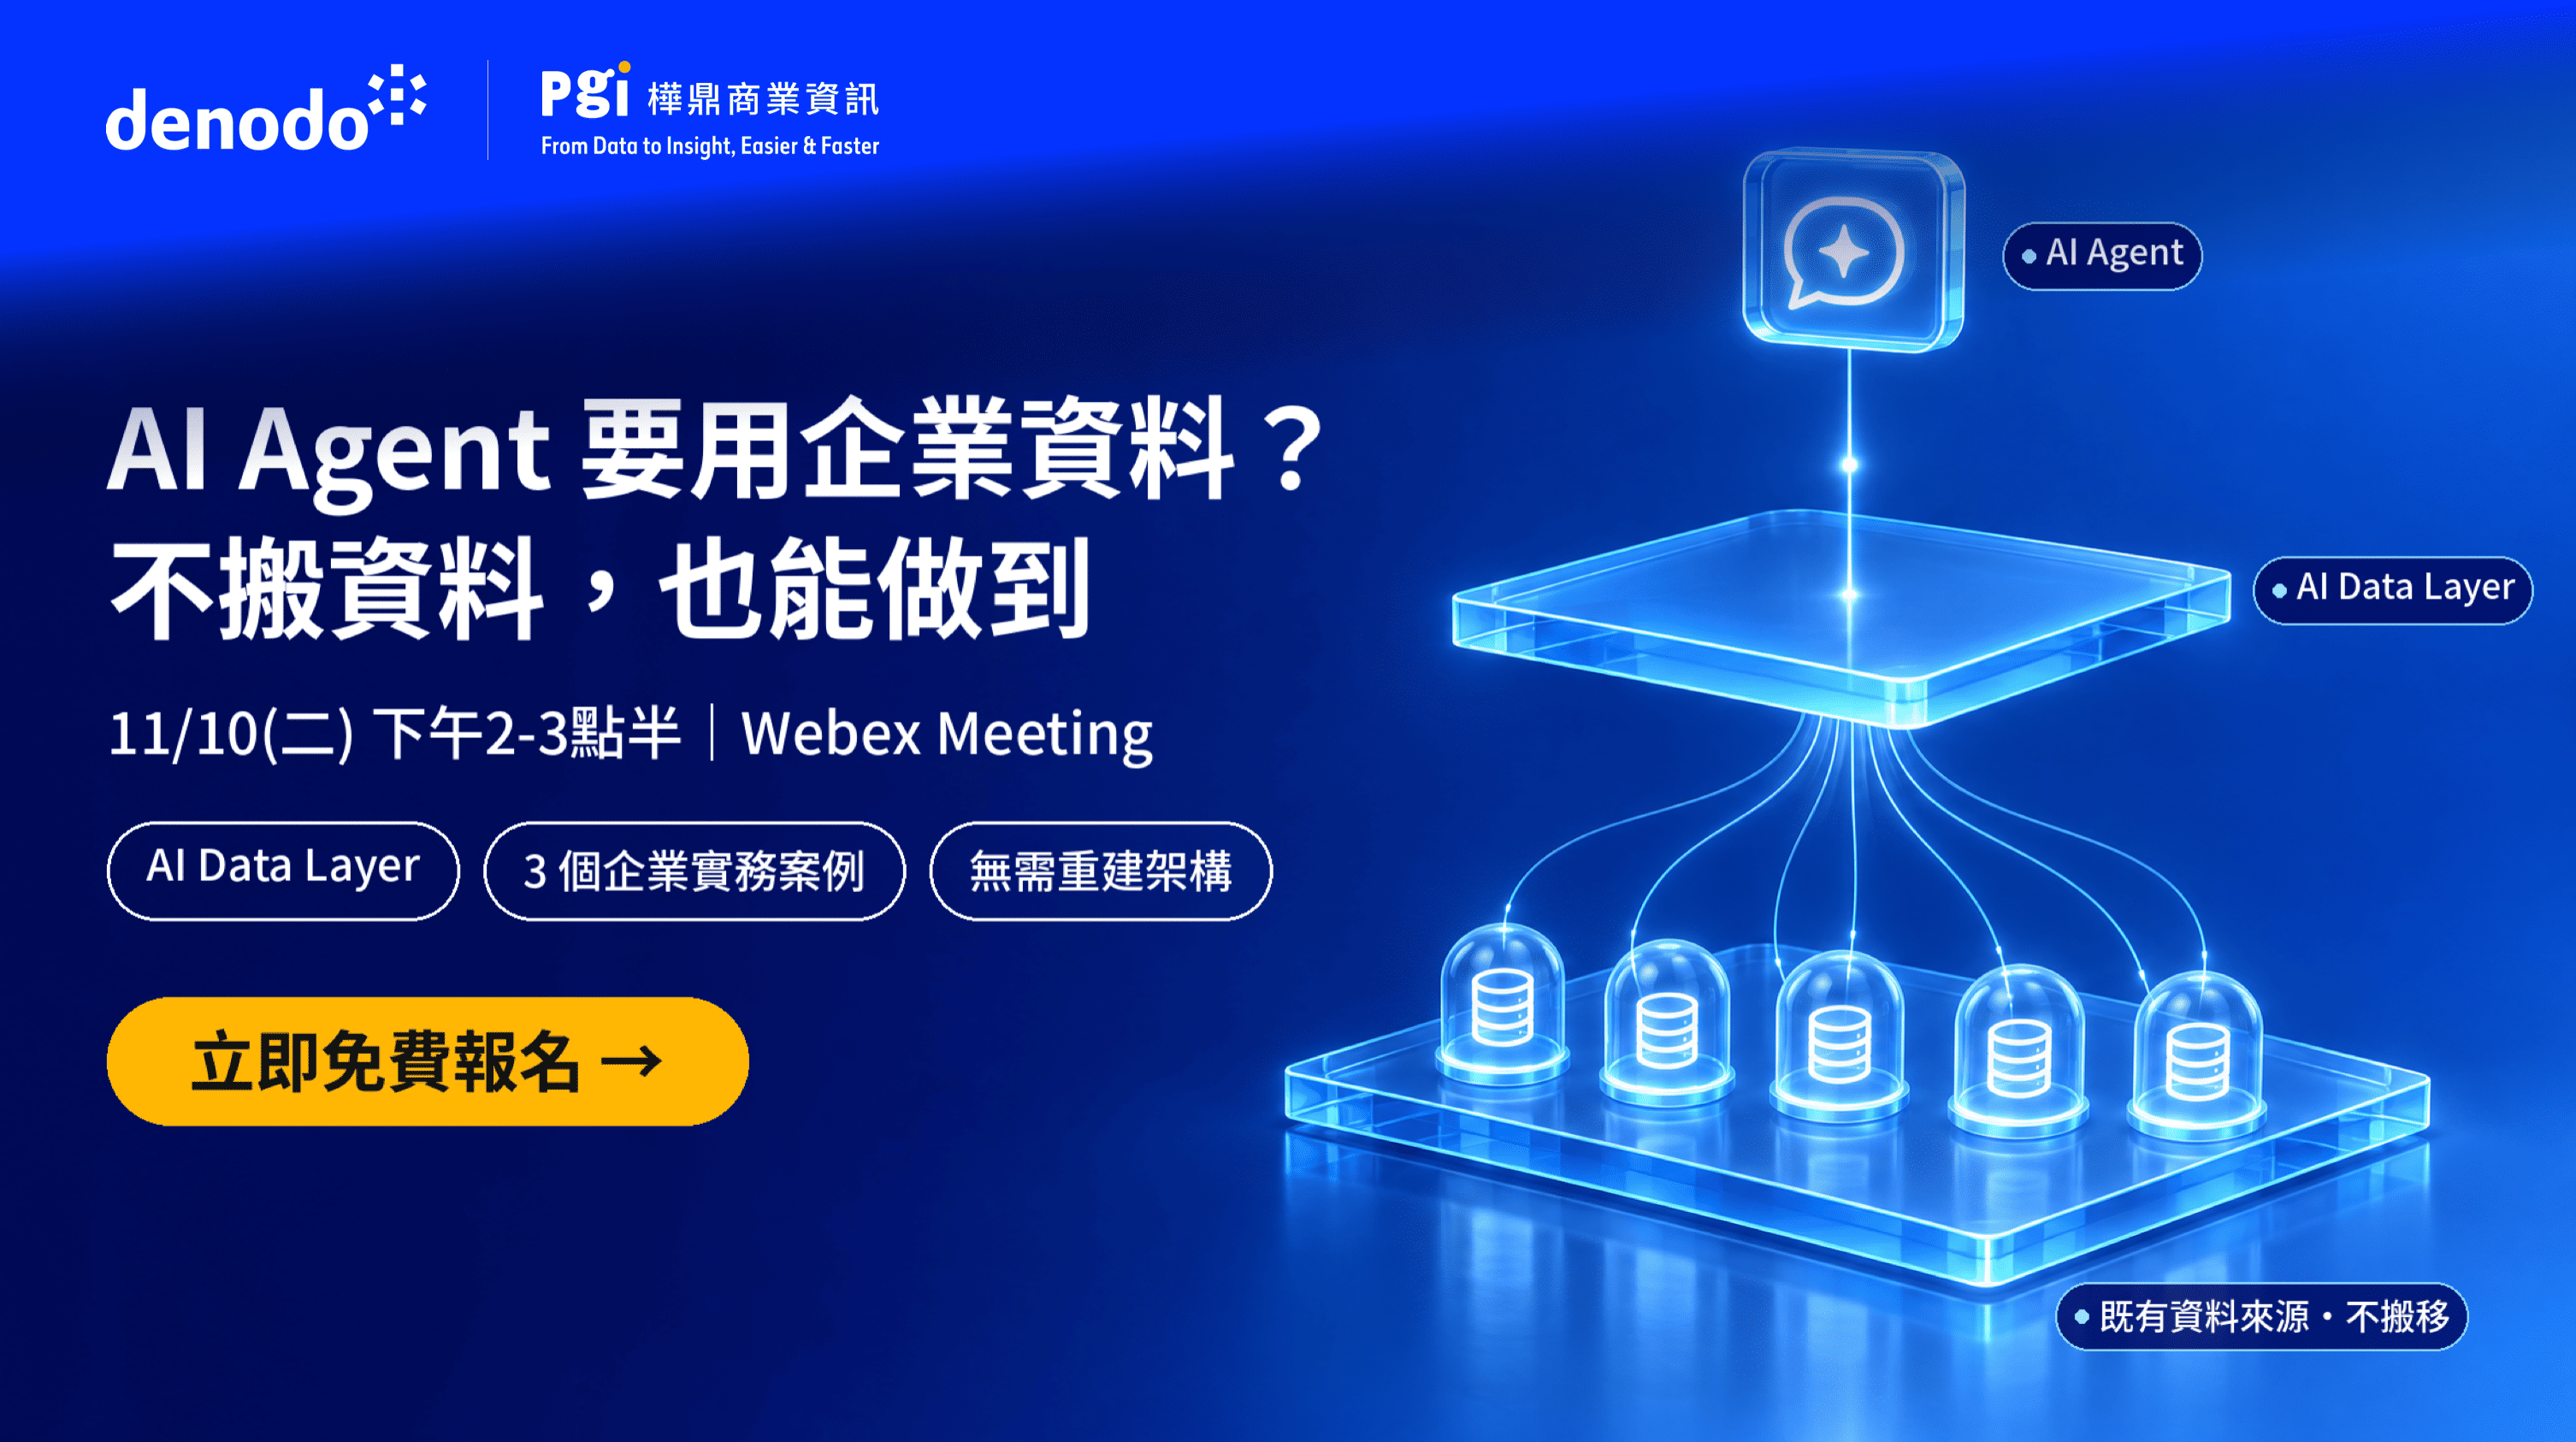
AI Data Layer 的做法相反。它不是替換你已有的 lakehouse、資料倉儲或 catalog,而是疊在它們之上的一層,補三件事:
不搬移資料,直接連到分散在雲端、地端、SaaS 的來源即時取數
用一致的語意層,讓不同系統對同一個詞有相同定義
以角色與屬性為基礎的動態遮罩與存取控制,讓 Agent 只能取得被授權的資料範圍
如果你的角色是下面任何一種,這場的內容會直接對應你手上的問題:
不必為每個 AI 專案重新評估資料整合的時間與風險。一層可重複使用的架構,讓下一個專案的資料準備時間縮短
不必為每個新系統重新接線,現有的倉儲、湖倉、catalog 投資維持原狀,不必因為要支援 AI 而重新選型
重用已定義好的業務語意與規則,讓不同的 AI 應用對同一批資料有一致的理解,減少事後對帳與除錯
這場活動會示範 AI Agent 如何透過 Denodo 取得分散在多個來源的資料,並用三個企業實務案例,對應三種不同的起點:
全球生技製造巨頭 Sanofi(超過 10 萬名員工、年營收 400 億美元以上)用 Denodo 資料虛擬化打造 Datahub,連接所有 SAP 系統,排程 500 多個日常工作、整合 200 項商業規則。資料交付速度提升 80%,新專案實施時間減少至少 50%,達到 100% 準確資料
一家服務數百萬會員的全國性健保公司,理賠授權原本要 7 到 14 天,人工從十幾個系統拼資料。改用 6 個專門 Agent 搭配 AI Data Layer,把審批時間壓到分鐘級
一家擁有多個品牌的中國一線汽車集團,資料分散在各品牌、各系統,導入 Denodo 後,查詢速度提升 20 倍以上,並釋出 6 個全職人力
現場也會介紹 Denodo Platform 9.5 ↗ 的最新能力,讓你知道這不是概念,是現在就能落地的技術
-
看懂AI Agent 一碰企業資料時,卡關具體發生在哪一層
-
判斷一個判斷框架:AI Data Layer 怎麼疊在你現有的 lakehouse 或資料倉儲之上,不必砍掉重練
-
對照三個對應不同起點的真實案例,找到最貼近你現況的那一個
-
行動下一步怎麼走:申請 POC,或到 12/2 新竹線下場當面交流 ↗
| 時段 | 內容 |
|---|---|
| 14:00–14:10 |
【開場】
市場現況與台灣 AI 基本法,企業資料為什麼是 AI Agent 的關鍵 |
| 14:10–14:40 |
【Demo】
AI Agent 如何在受管控下取得分散的企業資料(MCP、語意層、權限) |
| 14:40–15:10 |
【企業實務案例】
資料未打通、AI 專案卡整合、多事業體集團實例 |
| 15:10–15:30 | Q&A 與下一步 |
正在評估或已投入 AI/Agent 專案的 CIO、CDO、IT 主管與資料架構主管。不需要事先熟悉 Denodo 或資料虛擬化
議程分成策略層(為什麼、與現有架構的關係)與技術層(案例的架構細節)。不熟悉技術細節,也能掌握核心判斷框架
報名後會收到活動錄影連結,可以事後補看
正是這場的對象。AI Data Layer 疊在現有架構之上,不取代它